O que é Power BI e como ele funciona (Guia Completo)
Em abril de 2026 o Google lançou o Gemma 4, a nova geração dos seus modelos de inteligência artificial abertos. "Aberto" aqui tem um significado bem prático: você baixa o modelo, instala no seu computador e usa sem internet, sem assinatura e sem mandar seus dados para servidor nenhum.
Neste artigo você vai entender o que é o Gemma 4, no que ele é diferente do Gemini, qual versão cabe na sua máquina e o passo a passo para baixar e rodar em poucos minutos.
1. O que é o Gemma 4
Gemma é a família de modelos abertos do Google DeepMind, o mesmo time que desenvolve o Gemini. A diferença entre os dois está em onde o modelo roda.
O Gemini roda nos servidores do Google. Você acessa pelo aplicativo, pelo site ou pela API, e tudo o que você digita vai para a nuvem do Google antes de voltar como resposta.
O Gemma você baixa. O arquivo com os "pesos" do modelo (o resultado do treinamento) fica no seu computador ou no seu celular, e a resposta é calculada ali mesmo. Dá para usar no avião, numa rede corporativa fechada ou com documentos que não podem sair da empresa.
Segundo o Google, o Gemma 4 foi construído com a mesma pesquisa e tecnologia do Gemini 3. Ele é distribuído sob a licença Apache 2.0, que permite uso comercial, modificação e redistribuição. Na prática, uma empresa pode pegar o modelo, treinar com os próprios dados e colocar num produto sem pagar licença ao Google.
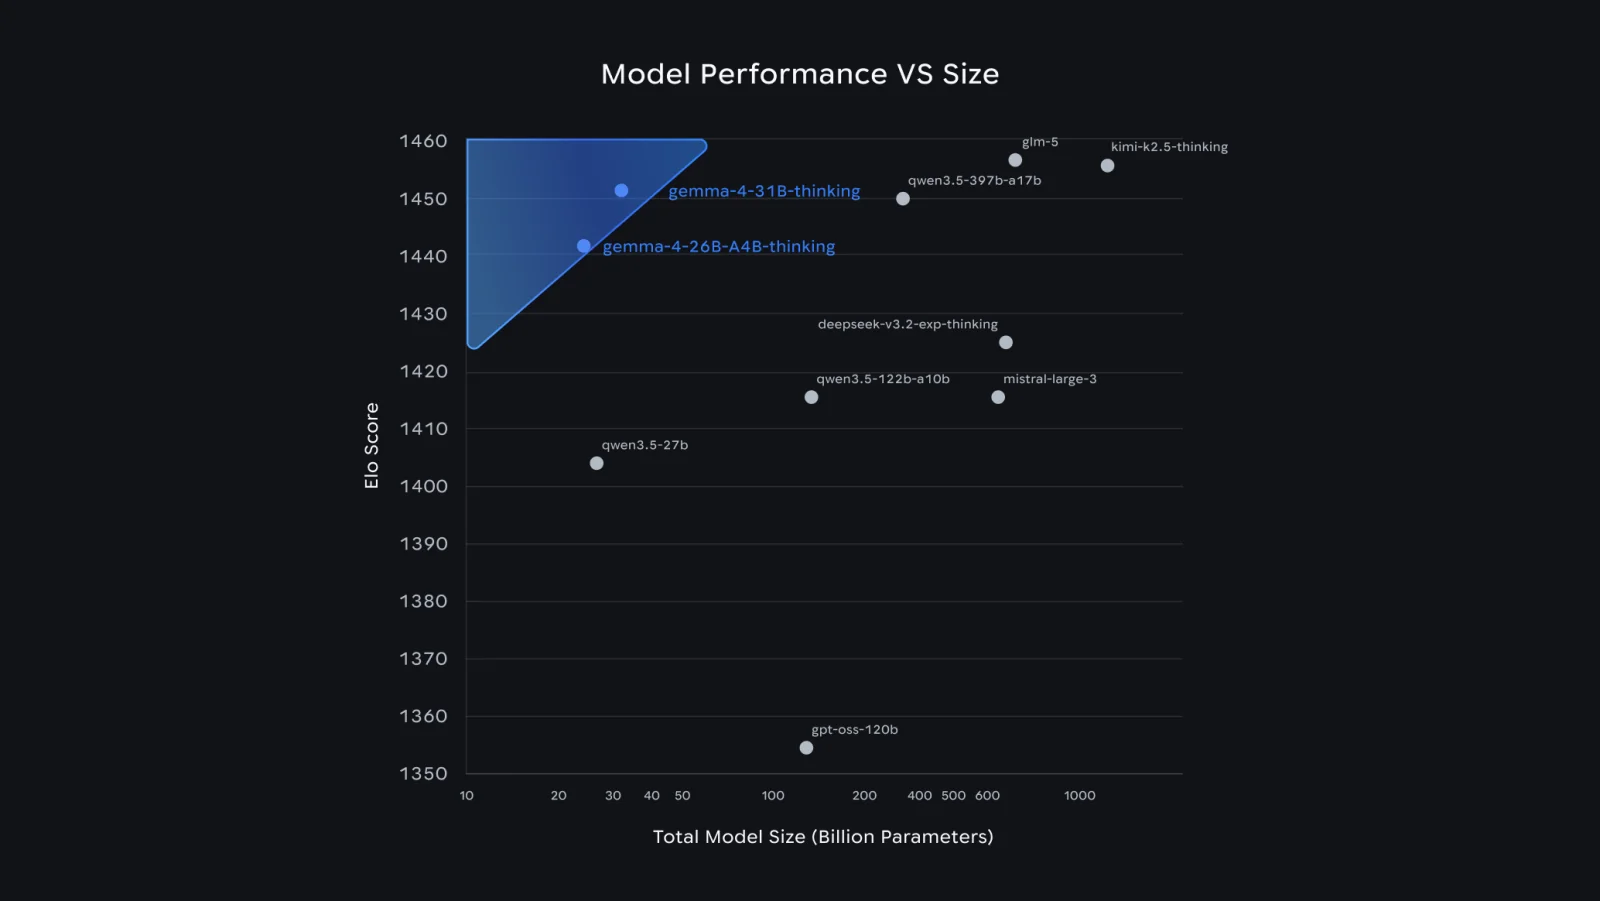
O gráfico acima é do próprio Google, então leia com a desconfiança de sempre. Mas o ponto que ele defende é interessante: no ranking Arena AI, a versão de 31 bilhões de parâmetros ficou em terceiro lugar entre os modelos abertos do mundo, à frente de modelos até vinte vezes maiores. Para quem vai rodar o modelo num notebook, tamanho é tudo.
O que o Gemma 4 faz
- Raciocínio. Todos os tamanhos têm um modo de "pensar" antes de responder, que ajuda em matemática, lógica e problemas de várias etapas.
- Agentes. Suporte nativo a chamada de função e saída em JSON, que é o que permite ao modelo usar ferramentas e executar fluxos de trabalho, como consultar uma planilha ou chamar uma API.
- Código. Geração e correção de código sem internet. O Google vende isso como um assistente de programação local.
- Imagem e vídeo. Todos os modelos leem imagens e vídeos. Isso inclui OCR, leitura de PDF, entendimento de gráficos e de telas.
- Áudio. As versões menores (E2B, E4B e 12B) aceitam áudio como entrada, para transcrição e tradução de fala.
- Contexto longo. 128 mil tokens nos modelos pequenos e 256 mil nos maiores, o suficiente para um livro ou um repositório de código num único prompt.
- Português. Treinado em mais de 140 idiomas, português entre eles.
2. Os cinco tamanhos
Aqui está a parte que importa para quem vai instalar. O Gemma 4 vem em cinco tamanhos, e a escolha depende da memória do seu computador.
| Versão | Para que serve | Download (LM Studio) | Memória recomendada |
|---|---|---|---|
| E2B | Celular, Raspberry Pi, computador fraco | 4,2 GB | 8 GB de RAM |
| E4B | Celular topo de linha e notebook comum | 5,9 GB | 8 GB de RAM |
| 12B | Notebook com 16 GB | 7,4 GB | 16 GB de RAM |
| 26B (A4B) | Computador com placa de vídeo | 15,6 GB | 32 GB de RAM ou GPU de 24 GB |
| 31B | Estação de trabalho | 19 GB | GPU de 24 GB ou 32 GB de RAM |
Os valores de memória são aproximados e dependem da versão quantizada que cada programa baixa. O tamanho do download é o que aparece no LM Studio em outubro de 2026.
O "E" de E2B e E4B significa "efetivo": o modelo tem mais parâmetros guardados, mas só usa 2 ou 4 bilhões por vez, o que economiza memória e bateria. O "A4B" do modelo de 26B indica que ele ativa só 3,8 bilhões de parâmetros a cada resposta, por isso responde quase tão rápido quanto um modelo pequeno, mas com qualidade de modelo grande.
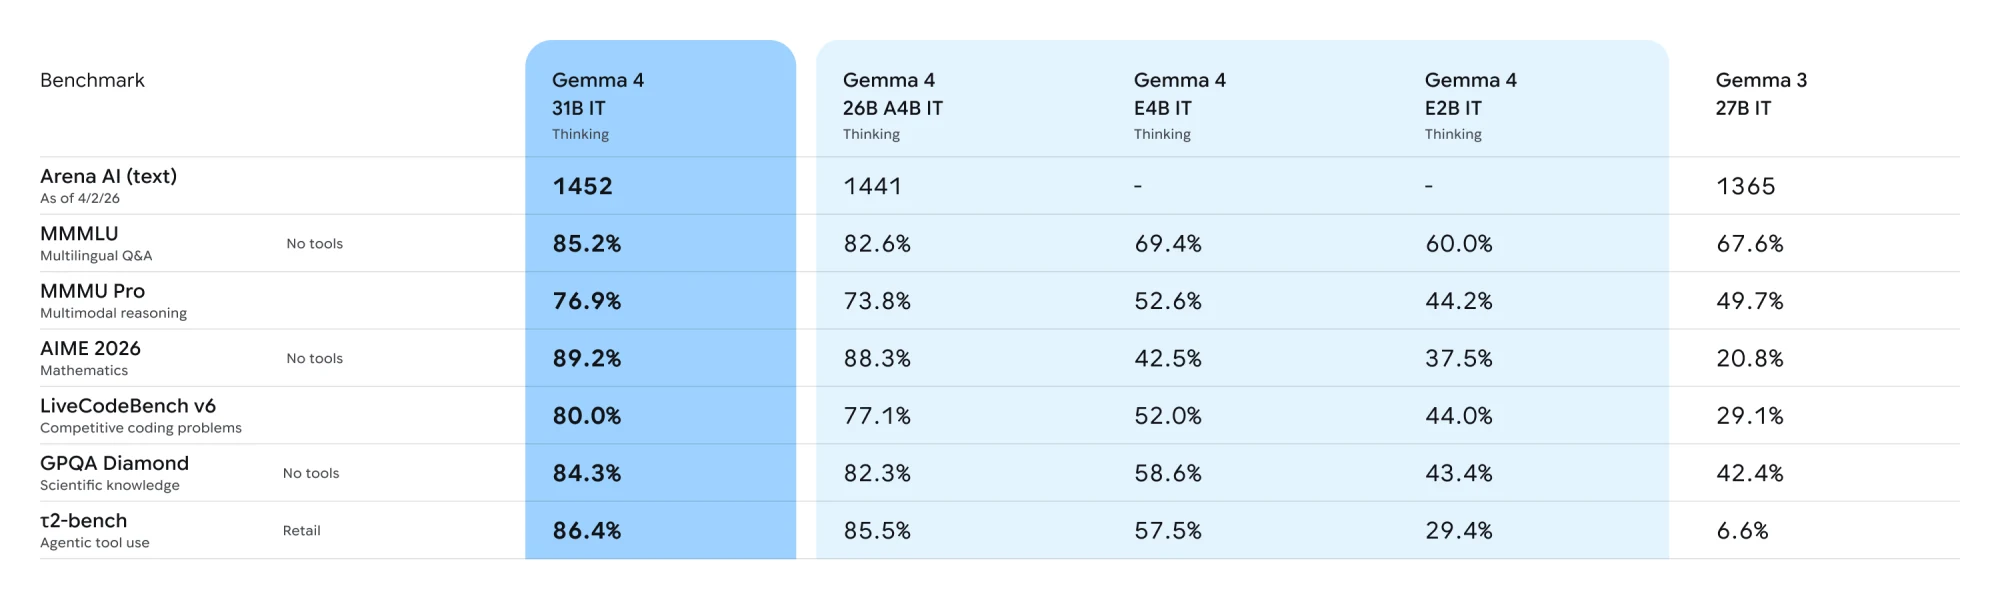
Repare na última coluna da tabela: o Gemma 3 de 27 bilhões, lançado um ano antes, perde para o novo E4B em quase tudo, e o E4B cabe num celular. Esse é o salto real desta geração.
O 12B foi lançado depois, em junho de 2026, para preencher o espaço entre o E4B e o 26B. Ele fica perto do 26B nos testes, com menos da metade da memória, e aceita áudio. Se você tem um notebook com 16 GB de RAM, é por ele que eu começaria.
3. Quando usar o Gemma 4 e quando ficar no Gemini ou no ChatGPT
Vale ser honesta: o Gemma 4 31B não é o Gemini 3 Pro. Os modelos que rodam na nuvem continuam mais capazes para tarefas difíceis, e você não precisa cuidar de instalação nenhuma.
O Gemma 4 faz sentido em quatro situações.
- O dado não pode sair da empresa. Contrato, prontuário, planilha de folha de pagamento. Com o modelo local, nada vai para fora.
- Você vai usar em volume. Cada pergunta a um modelo na nuvem custa tokens. No modelo local, o custo é a energia do computador.
- Não tem internet confiável. Avião, campo, fábrica, hospital.
- Você quer aprender como isso funciona por dentro. Rodar um modelo na própria máquina é a forma mais direta de entender tokens, contexto e memória.
Para pedir uma receita ou revisar um e-mail, o Gemini e o ChatGPT continuam sendo o caminho mais fácil.
4. Como testar sem instalar nada
Se você só quer sentir o modelo, não precisa baixar.
- No computador, abra o Google AI Studio e escolha o Gemma 4 31B ou o 26B na lista de modelos. É de graça, com uma conta Google.
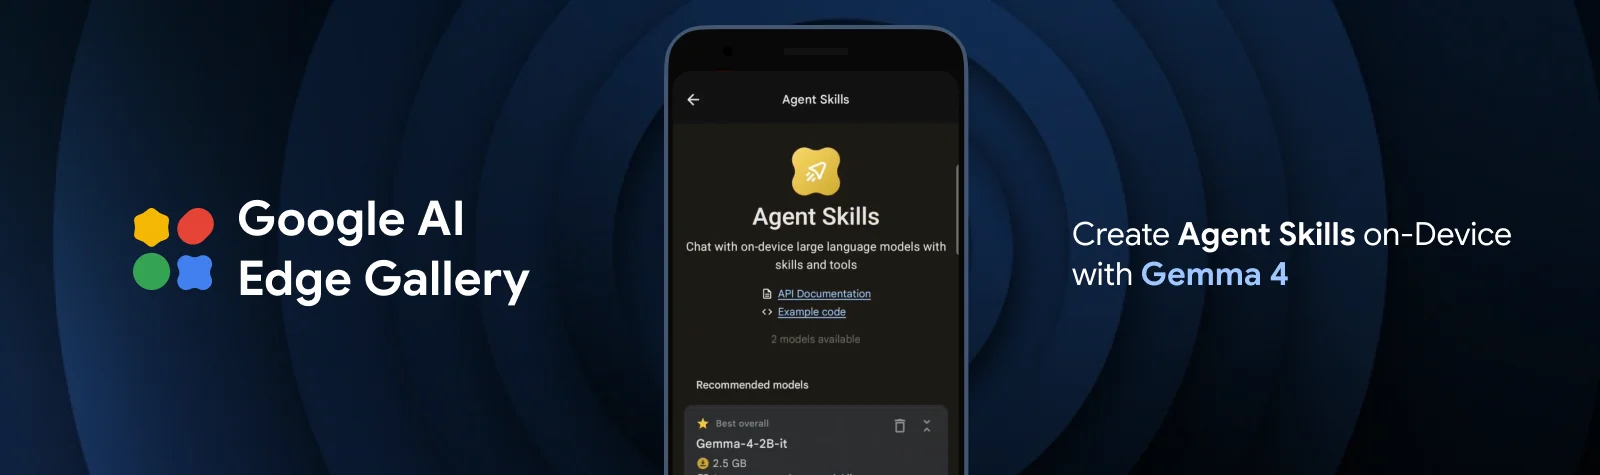
- No celular, instale o aplicativo Google AI Edge Gallery (Android ou iPhone). Ele baixa o Gemma 4 E2B ou E4B para dentro do telefone e roda offline. Depois do download, dá para colocar em modo avião e continuar conversando.
5. Como baixar e rodar no seu computador
O jeito mais simples é o LM Studio, um programa gratuito e todo visual, para Windows, Mac e Linux. Não precisa abrir terminal nem digitar comando.
- Entre em lmstudio.ai e clique em Download. A instalação é a de qualquer programa.
- Abra o LM Studio. No menu da esquerda, clique na lupa (Discover) e procure por "gemma 4". A página oficial do modelo é lmstudio.ai/models/gemma-4.
- Escolha o tamanho (comece pelo E4B) e clique em Download. O LM Studio mostra, antes de baixar, se o modelo cabe na memória do seu computador. Isso evita a frustração de baixar 19 GB e descobrir que não roda.
- Quando terminar, clique no ícone de balão (Chat), selecione o Gemma 4 no topo da tela e mande a primeira mensagem.
A primeira resposta demora alguns segundos porque o modelo está sendo carregado na memória. Da segunda em diante fica rápido. Para mandar uma imagem ou um PDF junto com a pergunta, arraste o arquivo para dentro da conversa.
Rodar um modelo de IA no próprio computador deixou de ser coisa de pesquisador. Com o Gemma 4, um notebook comum vira um assistente que lê documentos, entende imagens e escreve código sem mandar nada para fora. Se você trabalha com dados e quer entender IA de verdade, instale um, teste com um arquivo seu e veja o que acontece.